

[HER Hack-Astron # 7] [Open Source AI for Good] 招聘公平镜 Recruitment Fairness Lens

English summary. Recruitment Fairness Lens is a human-review aid for Chinese job ads. Spark-X2.6-4B locates text cues about sex, marriage/childbearing and caregiving conditions and quotes the exact evidence. The program validates the output and routes it to flag / review / unknown / clear using rules drafted with our legal co-researcher (608). A person accepts, modifies or rejects each cue and exports an audit record. It does not decide legality, report employers or rank companies.
The demo runs the official iFlytek MaaS spark-x2.6-4b; the cloud revision is not disclosed and its sampling is not deterministic. We also ran the open weights locally (HF revision d1b5f260, bf16, greedy) as separate evidence. The two are not equivalent environments.
A locked test on 30 new synthetic cases was run once on the frozen system: 15/30 agreement overall, 0/12 on the pre-marked disputed cases, 15/18 on the rest, with 2 network failures counted in the denominator (baselines: 10/30 and 13/30). This is agreement with one undergraduate law researcher's reference (supporting fields GPT-assisted), not legal accuracy. The flag/review distinction was not supported by this test. Development-set numbers below are exploratory only.
Project name and track
Project name: 招聘公平镜 Recruitment Fairness Lens
Track: Gender equality
Who this helps and what problem it solves
Target users: 招聘信息发布平台的审核人员、公共就业服务机构工作人员。他们本来就负有信息审核义务,也能要求发布方补充岗位材料。求职者也可以用它看懂招聘文字里的线索,但工具不要求求职者去调查企业。
Concrete scenario and problem: 中文招聘文本中,性别和婚育限制常见的写法有“男性优先”“宝妈勿扰”“已婚已育者优先”“承诺两年内不生育”,而且常常前面写一句“男女不限”。与此同时,很多写法看起来相关,其实是正常要求:出差、夜班、搬运能力,“欢迎女性申请”,新闻引用,已删除的旧条件,剧中角色和声部。关键词规则很难区分这两类。另外,“没有家庭/育儿负担”这类照护条件,不能直接等同于针对女性。
Expected public benefit: 帮审核人员更快定位需要人工核实的原文片段,并告诉他们还缺哪些事实、可以向发布方问什么问题。所有判断都由人确认。工具不认定违法,不自动举报,不做企业排名,不推断任何人的性别或婚育情况。
How Spark-X2.6-4B is used
Model source and revision:
- 本地开源权重(独立运行证据):Hugging Face
XHToken/Spark-X2.6-4B,revisiond1b5f26071101c27fcd07728e7a7770e428281f4,5 个权重分片的 SHA-256 已和 Hub 核对一致。用 transformers 4.57.1 在 Apple M3 16 GB(MPS)上运行,bf16,无量化,enable_thinking=False,贪心解码,max_new_tokens=640。86 条开发样本全部跑完,原始输出全部保存(公开仓库中的日志是过滤版,不含 16 条未授权样例)。 - 演示服务(官方 API):讯飞星辰 MaaS
POST /v2/chat/completions,model: spark-x2.6-4b(每次响应的model字段都核对过),thinking.type=disabled,max_completion_tokens=640。云端的具体 revision 和精度都没有公开,我们不声称它与上面的开源 revision 相同。 采样由服务端固定为 temperature=1、top_p=0.95,结果不是确定性的,与本地贪心推理不是等价环境。我们测试过 function calling 强制结构化输出,模型没有响应(0/18)。
The model's role in the application: Spark-X2.6-4B 读取招聘文本,输出 JSON:
- 语境
scope:当前招聘 / 引用或历史 / 培训 / 信息不足。 - 每一条线索
findings:原文片段、线索类型(明示性别、婚育条件、照护条件、语境暗示、声称例外)、性别关联程度、是否涉及照护。 - 待补充事实和一句说明。
模型不直接决定分流结果。程序负责:
- 逐字校验每个引用是否是原文的连续片段。
- 按规则把线索类型映射为 flag / review / unknown / clear。
- 从法学合作者核实过的法源白名单中显示编号。
- 推导是否需要人工复核。
人工最后对每一条接受、修改或拒绝,并导出审核记录 JSON。
Other models, tools, or services used, if any: 推理只用 Spark-X2.6-4B,没有用其他模型。开发过程用了 AI 辅助工具,见文末披露。
Demo (required: video OR illustrated walkthrough)
形式: 图文演示(真实运行截图和逐步说明)。
以下三个场景都是 2026-10-30 用冻结版本(Prompt v2.1 + 后处理 v2.3)真实调用 MaaS spark-x2.6-4b 的结果,输入均为合成文本。截图里的“人工”步骤是由 AI 工具自动操作的流程演示,页面上的审核人写的是“非真人审核”,不是正式的人工法律审核。这三个场景的人工记录早于下面的复核流程 v1.0,所以字段较少,状态名称也是旧版的。截图中的法源说明和 SOP 核查问题来自法学联合研究者 608,已获她授权公开。
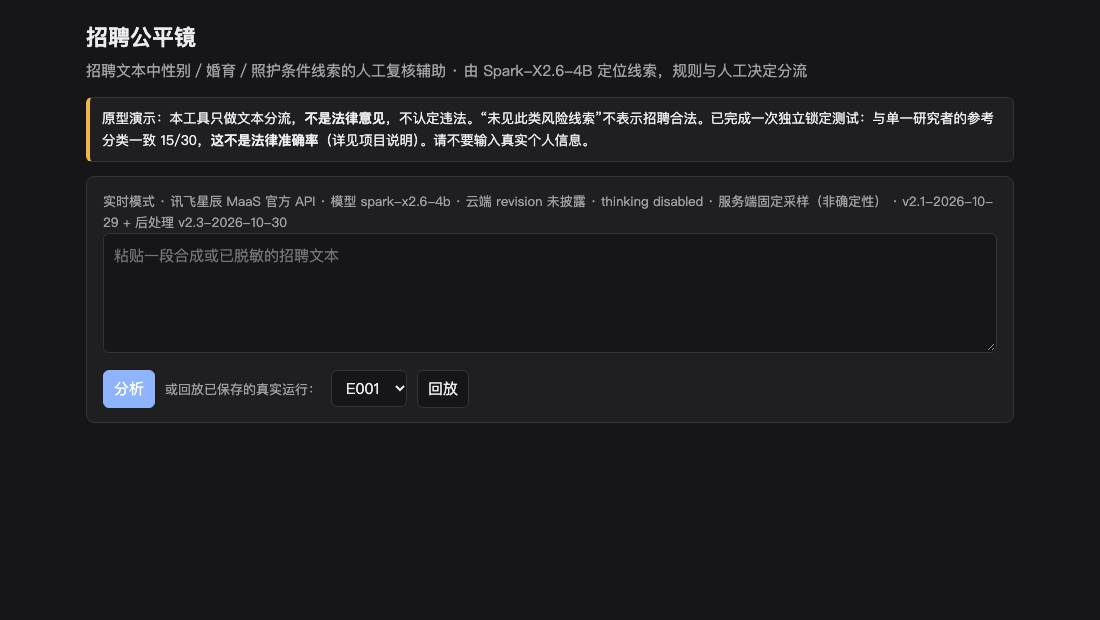
首页:顶部写明“不是法律意见”。模式说明行显示官方 API、模型 ID、云端 revision 未披露、服务端固定采样(非确定性)、Prompt 和后处理的版本。
场景 1:明确的婚育限制
输入: 【合成示例|场景1】诚聘行政助理:本科学历,形象好;入职须签署承诺书,保证两年内不生育;已婚已育者优先。
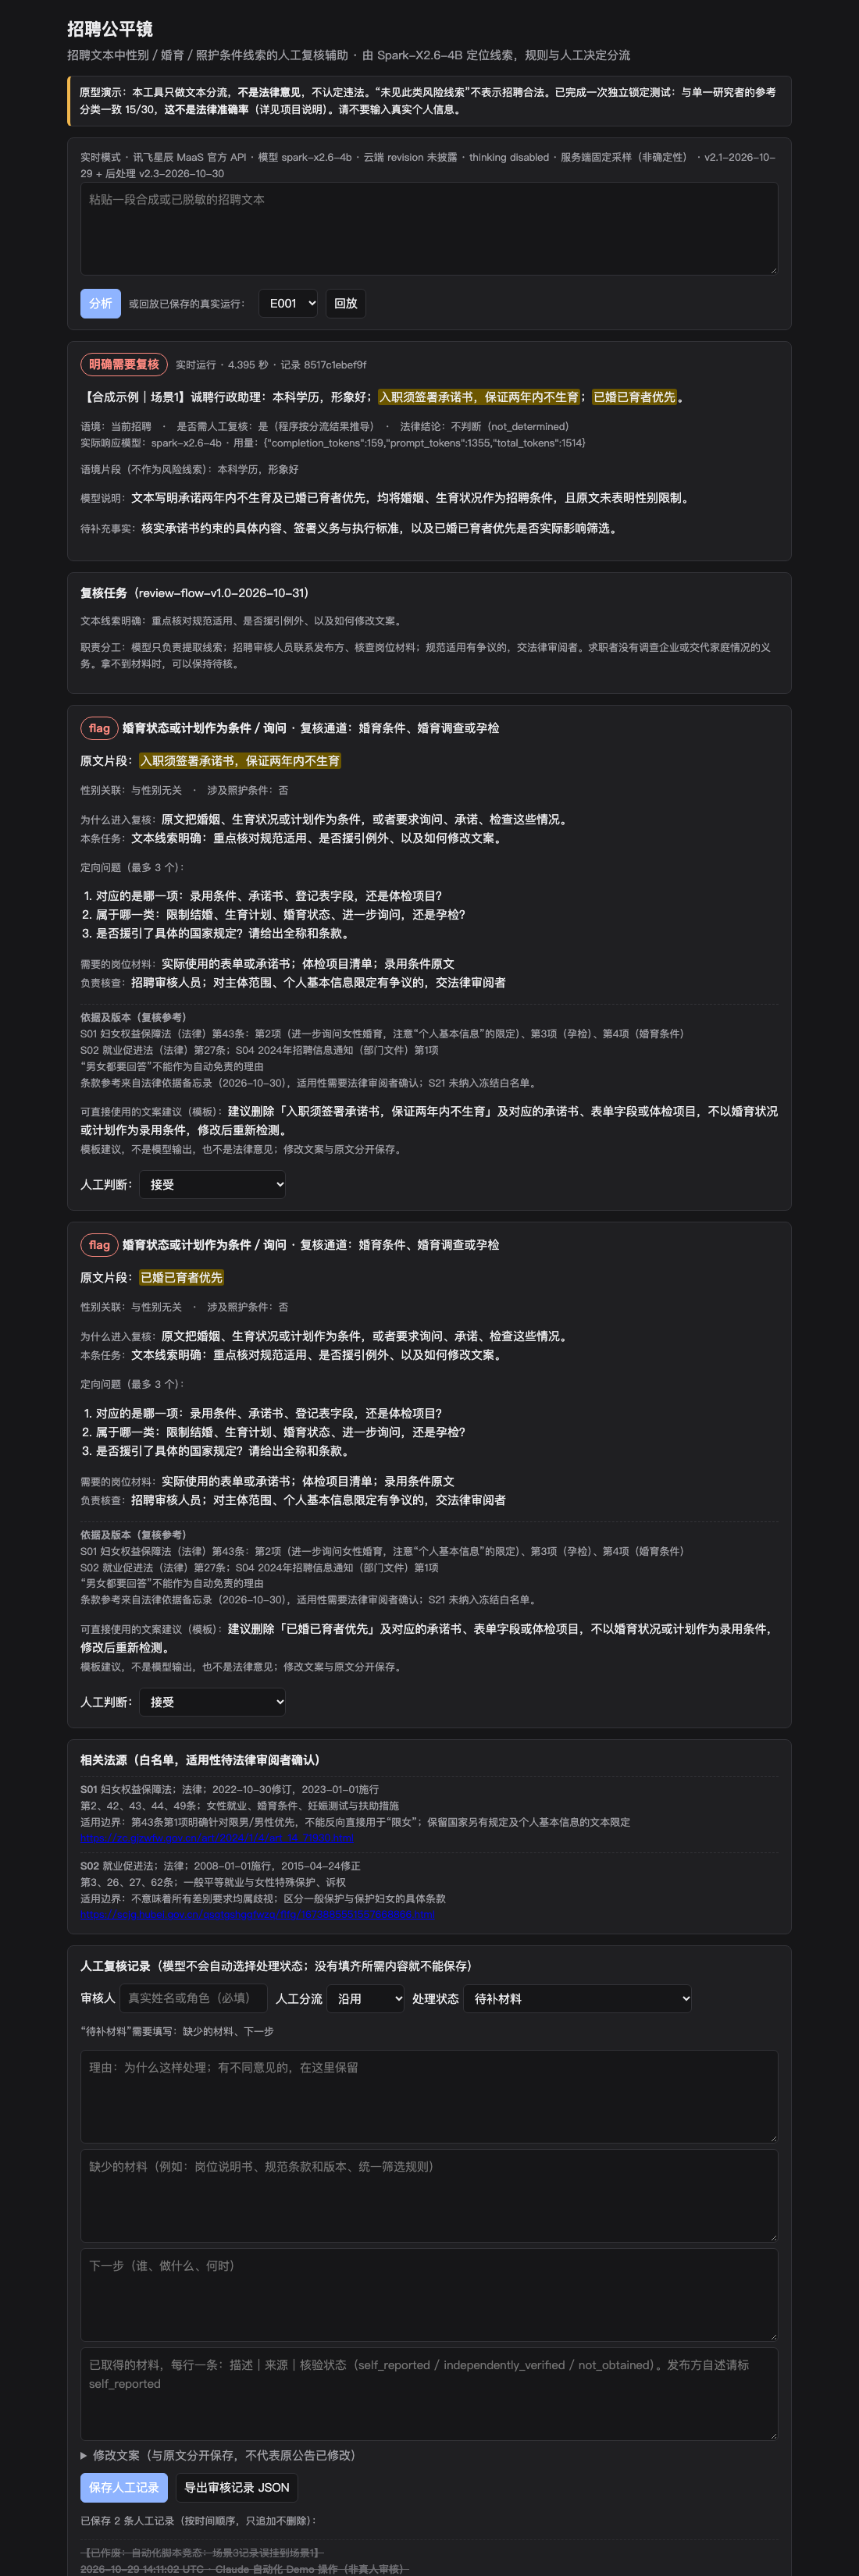
实际输出(4.4 秒): 两条婚育条件线索,都判为 flag:“入职须签署承诺书,保证两年内不生育”“已婚已育者优先”。原文高亮,“法律结论:不判断”,法源编号 S01、S02,模型说明和待补充事实。
人工步骤: 两条都“接受”,处理状态选“需法律进一步判断”,导出 JSON。(页面上划删除线的那条,是准备 Demo 时自动化脚本挂错的记录,已标为作废,原记录保留。)
场景 2:照护条件的不确定性
输入: 【合成示例|场景2】招聘项目协调员:需每月出差约一周,男女均可;希望候选人没有育儿负担,能全身心投入。
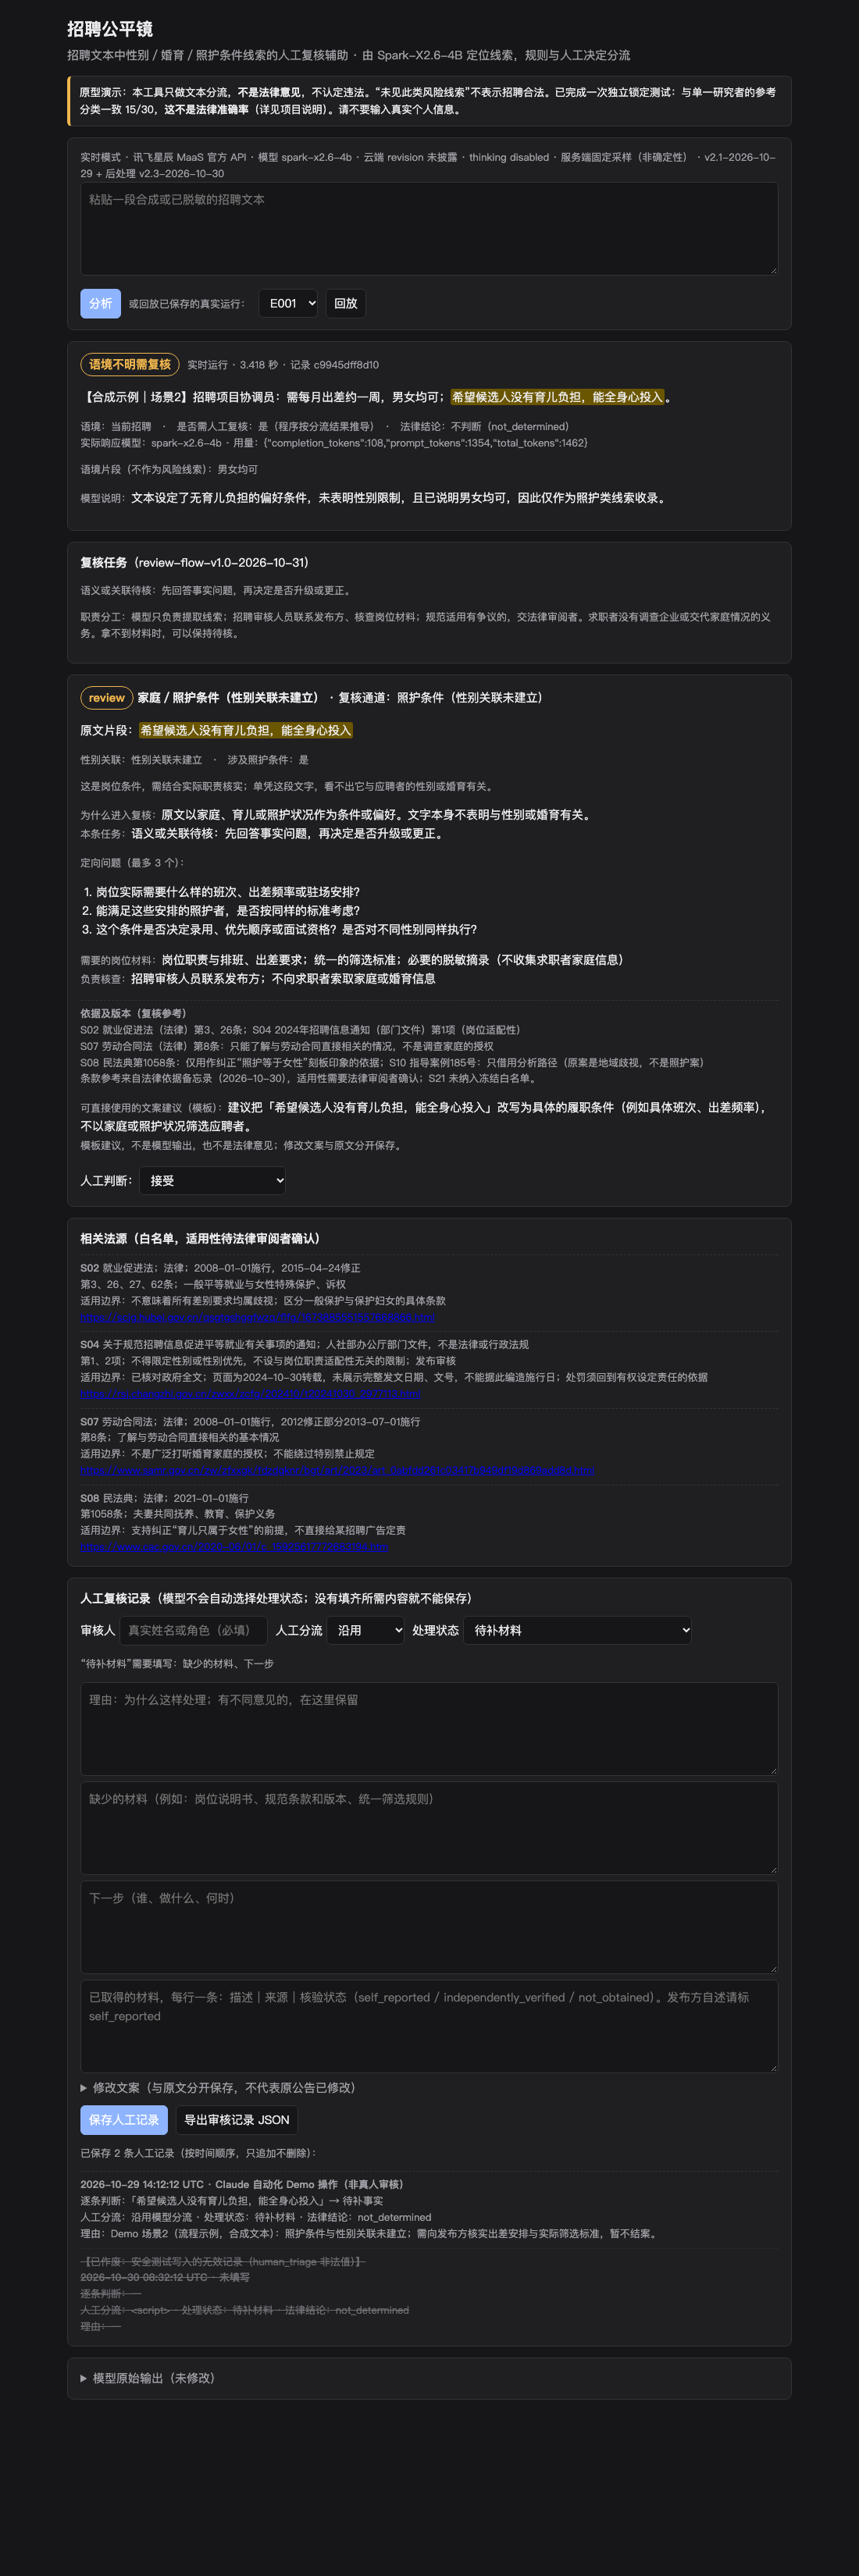
实际输出(3.4 秒): “希望候选人没有育儿负担,能全身心投入”判为照护条件 review,性别关联:未建立。页面附上 3 个向发布方核实的问题(不询问求职者)。出差要求没有报警。
人工步骤: 选“待补事实”,处理状态选“待补充材料”,不结案。这次的瑕疵: 模型没有填写“待补充事实”字段。
场景 3:声部表达(已知失败模式与人工纠正)
输入: 【合成示例|场景3】城市合唱团招募女高音声部团员,按试唱和视唱能力选拔,欢迎有合唱经验者报名。
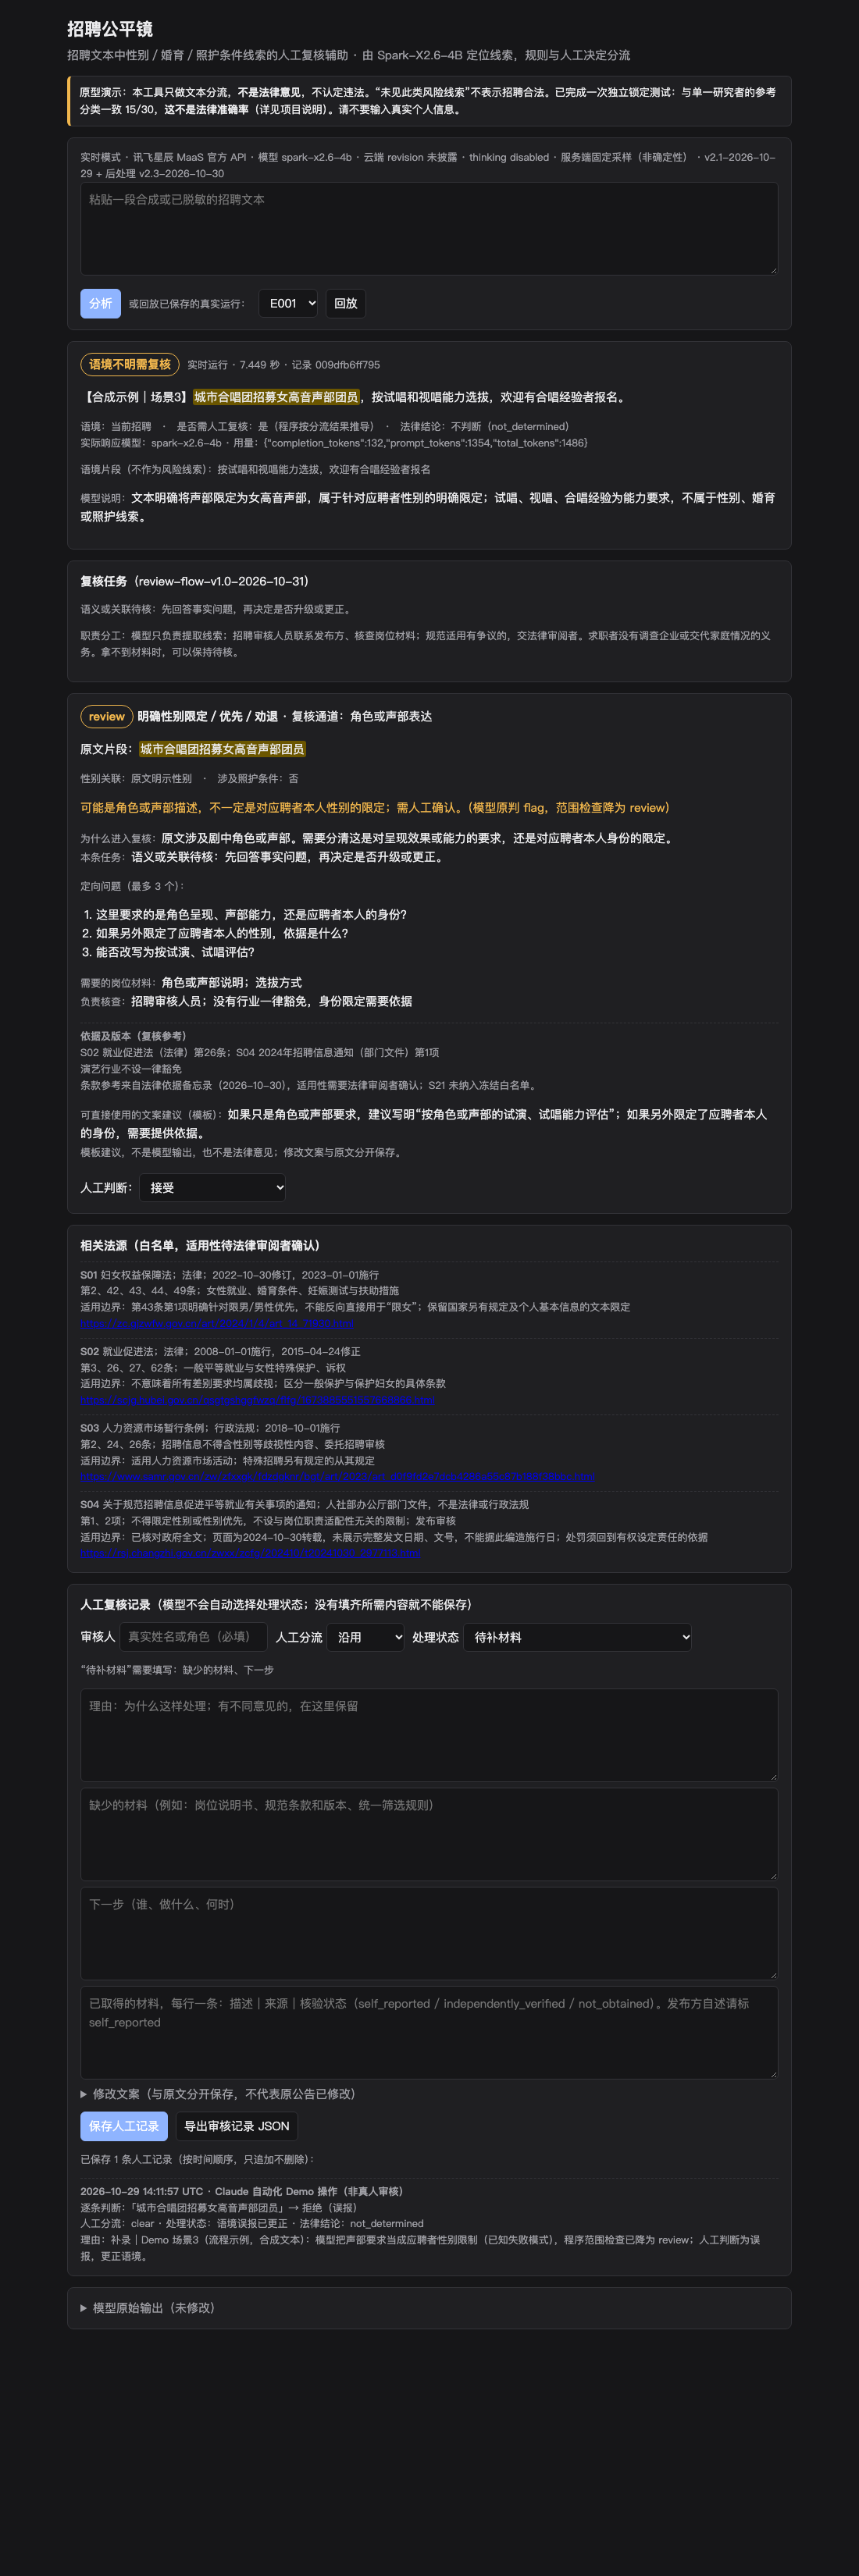
实际输出(7.4 秒): 模型错误地把“女高音声部”判为应聘者性别限定(explicit_sex)。程序的范围检查把它从 flag 降为 review,提示“可能是角色或声部描述,需人工确认”。
人工步骤: 选“拒绝(误报)”,人工分流改为 clear,处理状态选“更正语境误报”。如果文本另外直接限定应聘者本人的性别(例如“需为女性演员”),程序不会降级,仍然判 flag。
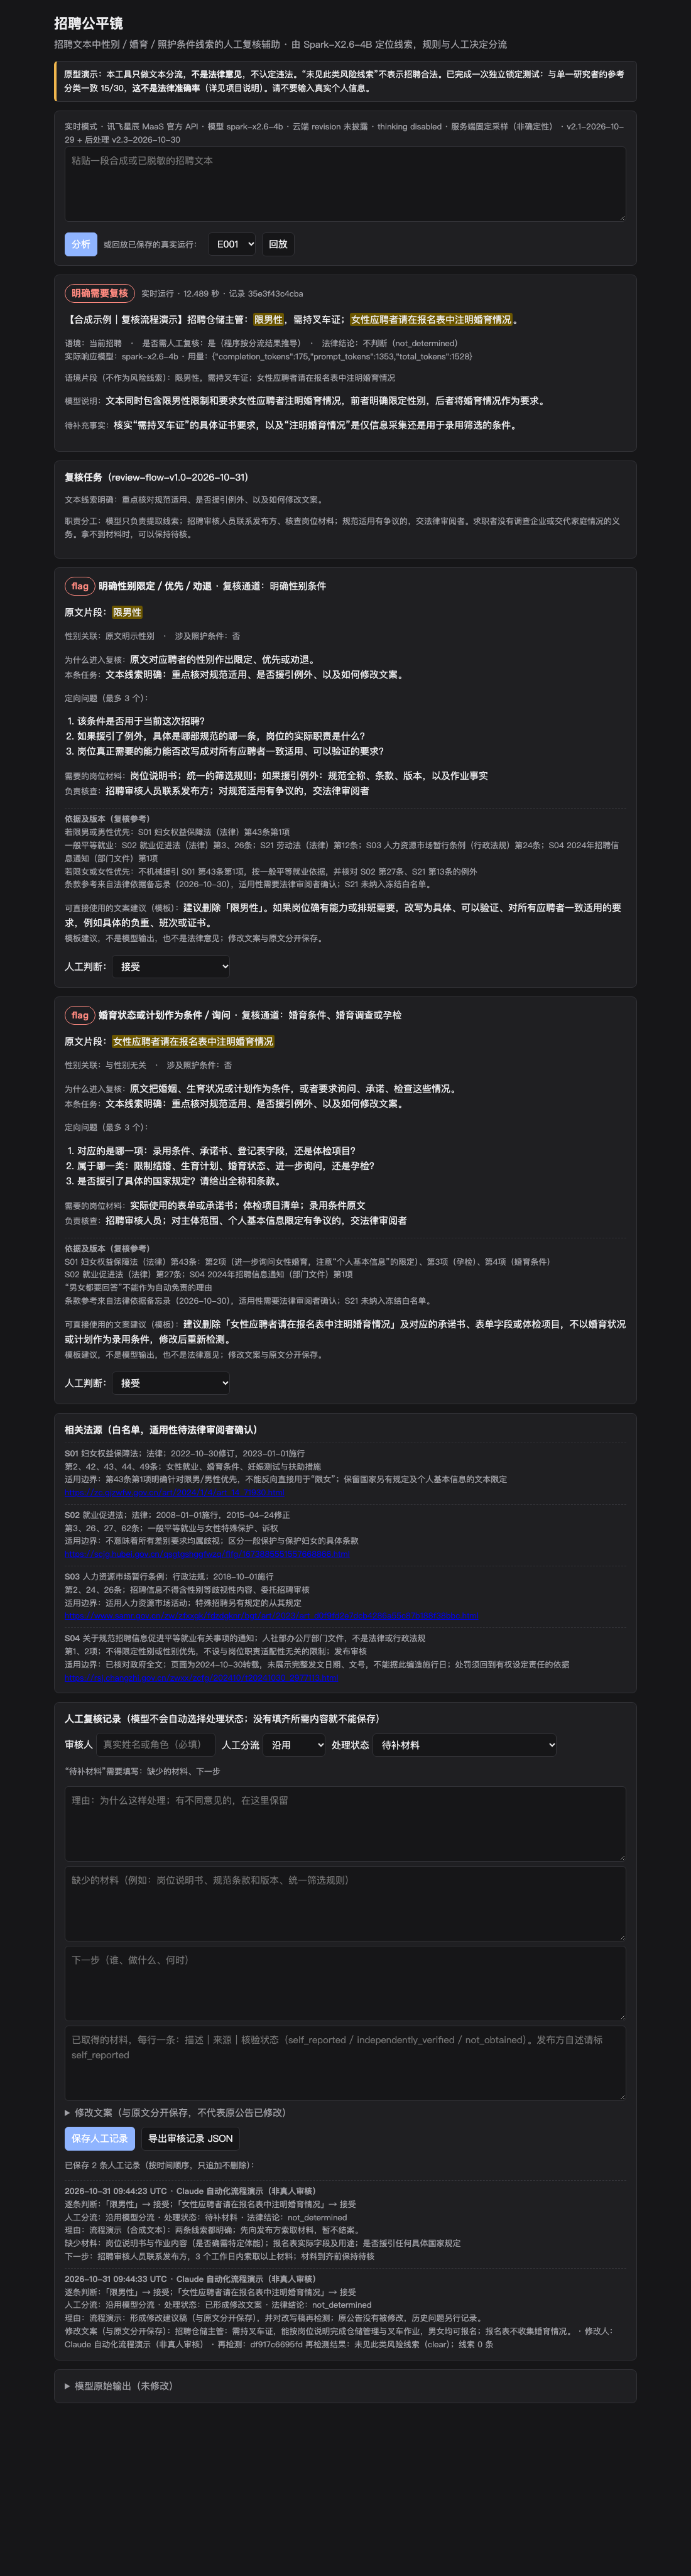
人工复核流程(review-flow v1.0,按法学联合研究者 608 的人工复核产品要求实现)
每条线索生成一张复核卡,内容包括:
- 本条任务:flag 侧重规范适用、例外和改写;review 先回答事实问题;unknown 列出缺失材料。
- 入队原因、最多 3 个定向问题、需要的岗位材料、负责核查的角色。
- 条款级依据参考,标明法规层级,适用性待法律审阅者确认。
- 文案模板。
处理状态有 6 个:待补材料、语境误报已更正、已形成修改文案、风险线索获补强、待核例外适用、保留不确定。每个状态都有结案条件,没有登记已取得的材料就不能选择收口类状态,服务端会直接拒绝保存。修改文案与原文分开保存,可以对修改稿再检测。
2026-10-31 用单独编写的合成文本做了一次完整演示,没有使用任何测试题:
- 输入“限男性……女性应聘者请在报名表中注明婚育情况”,模型实际返回两条 flag。
- 在没有材料的情况下尝试结案,被拒绝。
- 改为“待补材料”,写明缺少的材料和下一步。
- 形成修改文案,并对修改稿做一次真实再检测,结果为 clear。
- 导出 JSON。
原型局限:没有多人协作和权限;联系发布方要线下完成;证据只能以文字登记;文案建议是模板。我们不声称已经在真实场景完成闭环复核,也不声称能节省时间。
How to reproduce
Code repository or runnable example: github.com/yangmengze608-afk/recruitment-fairness-lens(公开,当前 commit 8752e3389b2acdb94aaafeaa3acec2f8ee4ed9e8)
rfl/prompt_v2_1.py与冻结记录逐字节一致(SHA-25662a40a7f…)。仓库还包含已授权的标注规则、SOP 核查问题和法源适用边界说明。- 以下内容未公开:AI 辅助研究标签、16 条回归样例、法学研究备忘,以及锁定测试的案例、逐条参考标签和争议记录(只公开汇总,见
docs_v5/LOCKED_TEST_RESULT_SUMMARY.md)。仓库里的日志是过滤版:删除了回归样例所在的行,替换了本机路径,其余内容逐字保留。 - 详见仓库中的
RELEASE_NOTE.txt和docs_v4/PUBLIC_PERMISSIONS.md。
Setup and run instructions: 见仓库中的 REPRODUCE.md。下面的三种模式在公开仓库里都能直接运行。开发集和锁定测试的评分需要未公开的标签,公开仓库无法复算;公开的是汇总结果。
python3 -m unittest discover -s tests            # 39 个测试,只需要标准库
# 官方 API 模式(需要自己的 MaaS Key;Key 只在本地服务端读取)
mkdir -p ~/.config/rfl && pbpaste > ~/.config/rfl/xfyun_api_key && chmod 600 ~/.config/rfl/xfyun_api_key
python3 mvp/server.py --provider xfyun_maas      # http://127.0.0.1:8765
# 本地开源权重模式
hf download XHToken/Spark-X2.6-4B --revision d1b5f26071101c27fcd07728e7a7770e428281f4 --local-dir ../models/Spark-X2.6-4B --exclude "images/*"
pip install -r requirements.txt && python mvp/server.py --provider local_transformers
# 只读回放(不调用模型,页面会标注“回放”)
python3 mvp/server.py --replay outputs_v3/maas_v2.1_plus_pp2.3_dev86/records.jsonl --replay-raw outputs_v3/maas/dev86_v2.1_raw/raw.jsonl
Runtime and versions: 本地:Python 3.12,transformers 4.57.1,torch 2.14.1。云端模式和网页只用 Python 标准库。
Hardware and precision/quantization: 本地:Apple M3 16 GB,MPS,bf16,无量化。云端:硬件和精度未披露。
Key prompts and inference settings:
- Prompt v2.1(
rfl/prompt_v2_1.py)。只把 id 和招聘原文发给模型,文本中的指令一律不执行。 - 后处理 v2.3,每一项修复都有记录,原始输出保留:
- 近似键名修复(例如
missing_fs→missing_facts) - 字符串外重复逗号修复
- 引号内引用的法律词不算模型下的结论
- 角色或声部的范围检查(flag 降为 review,不会降为 clear)
- 近似键名修复(例如
- 冻结哈希:
docs_v3/FREEZE_v2.1_pp2.3.json。之后只改过界面和安全相关的代码,记录在docs_v4/FREEZE_ADDENDA.json,推理部分没有改。
Results and limitations
Observed results and how they were evaluated: 独立锁定测试是主要结果,开发集结果只作探索性参考。
独立锁定测试结果(2026-10-31,冻结版本,只运行一次)
流程:评分协议在收到测试输入前预注册(docs_v5/LOCKED_TEST_SCORING_PROTOCOL.md v1.1)→ 只收到 case_id 和原文 → 运行一次 → 封存预测并登记哈希 → 校验后才打开参考分类。与 86 条开发集精确重复 0 条。
| 与参考分类一致 | 全部 30 条 | 争议 12 条 | 其余 18 条 | 输出有效 | 人工队列 TP/FP/FN |
|---|---|---|---|---|---|
| Spark 冻结系统(官方 API) | 15/30 | 0/12 | 15/18 | 28/30 | 16 / 5 / 0 |
| 基线 A(原始关键词规则) | 10/30 | 4/12 | 6/18 | 30/30 | 2 / 4 / 14 |
| 基线 B(修订规则,看着开发集写的) | 13/30 | 3/12 | 10/18 | 30/30 | 4 / 3 / 12 |
Spark 的 30 条分开看:15 条一致;2 条非争议案例分类不一致;11 条争议案例分类不一致;2 条网络请求失败(连接被重置,没有模型输出,留在分母里,不重跑);JSON 无法修复的 0 条(1 条经记录的修复后有效)。
怎么理解这些数字:
这不是法律准确率。 争议案例不能作为认定模型法律判断错误的依据,但 0/12 也不能全部归因于参考标注。11 条有输出的争议案例,系统和研究者的判断都不一致:
- 系统把明确的婚育或性别限制文字一律判 flag,研究者保留 review(5 条);
- 系统把照护条件放进复核,研究者判 clear(3 条);
- 系统把声称例外的条件判 unknown,研究者判 review 或 flag(2 条);
- 语境暗示的判断不同(1 条);
- 另有 1 条网络失败。
这里面有规则差异:系统实现的是 10-28 版分流规则,研究者本轮的判断有所不同。也有系统自身的局限:冻结规则把明确线索一律映射为 flag,系统无法表达“文字明确,但仍需先核实”这样的判断。哪一方的分流更合适,这次测试没有结论。如果采用研究者的口径,现有规则需要修改。
flag 和 review 的区分没有得到这次测试的支持:参考为 review 的 7 条,系统没有一条判为 review;系统判为 review 的 6 条,参考也都不是 review。部分原因是结构性的:冻结规则下,明确线索一律为 flag。
人工队列的“16 条没有漏”里,有 2 条是网络失败转人工,不是模型发现的;模型实际发现 14/16。这个指标也不是歧视识别率。
照护条件被推断为性别:0/3。引用都是原文连续片段(有输出的条目);语义上是否支持线索本次未评估。
基线 A、B 在争议案例上更高,主要是因为它们对大量文本都判 clear。基线 B 在开发集上是 86/86,到这批新案例上只有 13/30,这也说明开发集分数不能当作效果证据。
只有 30 条,且是单次运行,云端采样有随机性,不做统计显著性的说法。测试后我们没有修改系统重测;今后如果修改规则,这 30 条只能算开发集。
测试案例和逐条参考标签未公开,所以外部无法复算这组数字。
开发集结果(探索性,不是正式成绩):
- 开发集共 86 条合成文本:
- 50 条原始案例,标签是法学联合研究者授权下的 AI 辅助研究意见,没有经过逐条人工确认,不是金标准。
- 16 条法学研究提供的回归样例。
- 20 条工程探针。
- 这些样本都参与过 Prompt 设计,v2.1 的部分规则还直接用到了开发集的措辞。所以下表只能说明流程可行,不是法律识别准确率。
| 开发集 86 条 | 本地开源权重 v2.1 | 本地 + 后处理 v2.3 | 官方 API v2.1(原始输出) | 官方 API + 后处理 v2.3 |
|---|---|---|---|---|
| 四分类与研究标签一致 | 79/86 | 81/86 | 68/86 | 78/86 |
| 输出通过校验 | 84/86 | 86/86 | 73/86 | 85/86 |
| 引用是原文连续片段 | 100% | 100% | 100% | 100% |
| 单条延迟中位数 / P95 | 22.4 s / 43.7 s | 同左 | 4.1 s / 7.2 s | 同左 |
- 以下三类错误在四种配置下都是 0:review 被判为 flag(0/8)、unknown 被强行定类(0/5)、照护条件被推断为性别(0/7)。
- 引用、历史或否定语境被误报:本地 0/18,官方 API 1/18。
法律工作分三个层次,需要区分清楚:
- 已经完成:法学联合研究者 608 整理了法律依据和法源索引,识别了争议点,研究了标注规则、人工复核流程和照护责任专题,对规则做了审查,并与项目负责人讨论确认了主要规则。
- AI 辅助、未逐条人工核实:开发集使用的 50 条研究标签。
- 本次独立锁定测试:608 主导法律测试设计,GPT 辅助生成 30 条合成招聘案例并整理支持字段;608 本人完成参考分类的首轮判断及复审。这是单一法学本科研究者的参考,不是多专家金标准,也没有律师审定。
Failure cases and current limitations:
- 剧中角色和声部描述(“扮演成年男性角色”“女高音声部”)在本地和云端都被模型误报为性别限制,开发集里 4/4。目前靠程序降为 review、交人工兜底,这是规则补丁,不代表模型能力。
- “欢迎女性申请”仍然会被误报。模型有时不填写“待补充事实”。
- 云端随机采样会导致 JSON 键名拼错、多出逗号等格式问题:原始输出有 13/86 条无效,修复后还剩 1/86。无效的输出交人工处理,不会被当作 clear。
- 工具只看文字,无法核实岗位的真实需要、“国家规定例外”是否成立,或者企业实际怎么录用。clear 只表示所给文字里没看到本产品关注的线索,不代表合法。
- 锁定测试中暴露的问题:
- 面向照护者的福利安排被误报为照护条件;
- 招聘主管口头表达的隐含偏好被判得偏轻(review,参考为 flag);
- 运行时网络不稳定:2 条失败,3 条重试后成功,延迟中位数 7.7 秒,比开发集慢。
- 没有做过真实用户研究,也没有使用任何真实招聘数据。
Contributors and disclosure
Individual / team: 团队,2 名真人成员
Contributor profiles and respective contributions:
- yangmengze608-afk(项目负责人;GitHub:yangmengze608-afk):产品、AI 技术、工程验收、实验设计与最终提交。
- 608(法学联合研究者,GitHub:608tt):法律依据与法源核实、争议识别、标注规则与分流原则设计、人工复核 SOP、案例分析、法律边界与产品设计讨论;主导独立测试的法律案例设计,审核由 GPT 辅助生成的 30 条合成招聘案例,完成参考分类的人工首轮判断与复审(其中 12 条保留显著争议)。
- 团队 2 人,女性贡献者占比 50%(608)。
AI-assisted development disclosure:
- Claude Code(Anthropic):编写并运行工程代码、评估脚本、网页和文档,Demo 截图里的流程操作也由它完成。
- ChatGPT:独立审阅;辅助法学研究资料的检索整理和标注初审;生成锁定测试的 30 条合成公告,转录研究者的判断并整理支持字段。
- AI 工具不是团队成员。法律规则由真人研究者讨论确认,50 条研究标签没有经过逐条人工确认。
Data sources and authorization: 所有样本都是原创合成文本,不含真实企业或个人信息。法源引用官方或政府网站,法源说明、标注规则和 SOP 问题已获 608 授权公开。锁定测试材料和研究标签未公开。仓库、日志、截图和导出文件中没有 API Key。